목차5개 항목
출처와 참고
「비교」 절의 복잡도 개선 흐름은 CrashCourse의 「Crash Course Computer Science」 강의를 바탕으로 보강했다. 다른 최단 경로 알고리즘으로 가는 안내는 fru1tworld/cs-basic 모의 면접 질문 목록의 「자료구조」 질문을 바탕으로 보강했다.
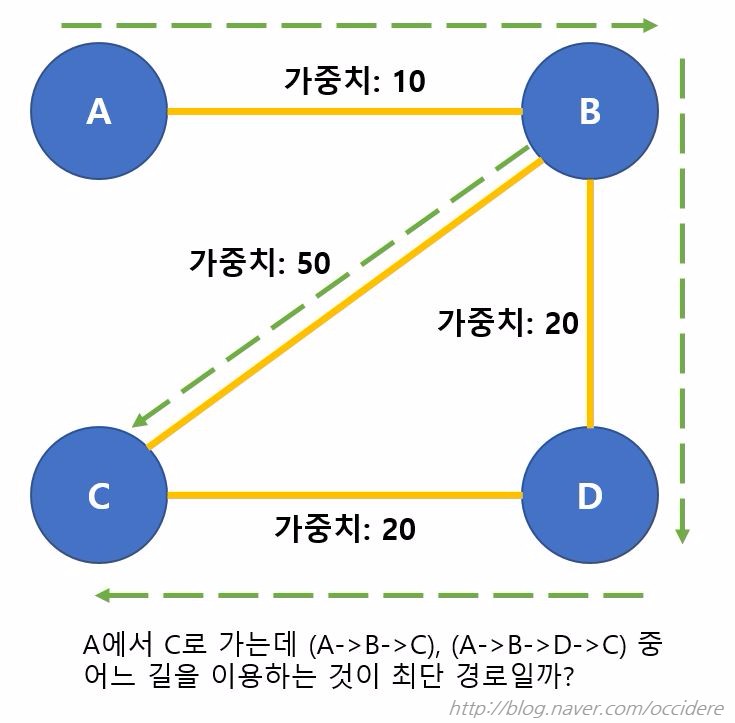
다익스트라(Dijkstra) 알고리즘은 한 출발 정점에서 다른 모든 정점까지의 최단 거리를 구한다. 간선 가중치가 모두 같다면 BFS로 충분하지만, 가중치가 서로 다르면 "먼저 도착한 경로"가 최단이라는 보장이 없으므로 다익스트라가 필요하다.
핵심 아이디어
다익스트라는 그리디 + 거리 갱신(relaxation) 알고리즘이다.
- 최단 거리 테이블을 모두 무한대로, 출발 정점만 0으로 초기화한다.
- 아직 확정되지 않은 정점 중 현재 거리가 가장 짧은 정점을 고른다. (그리디 선택)
- 그 정점을 거쳐 이웃으로 가는 거리
dist[now] + cost가 기존dist[next]보다 짧으면 갱신한다. - 모든 정점이 확정될 때까지 2~3을 반복한다.
2단계에서 고른 정점의 거리는 그 순간 최종 최단 거리로 확정된다. 가중치가 음수가 아니라면 다른 경로로 돌아와서 더 짧아질 수 없기 때문이다. 그래서 다익스트라는 음의 가중치가 있으면 쓸 수 없다. 음수 간선이 있으면 벨만-포드 알고리즘을 쓴다. 조건별로 어떤 최단 경로 알고리즘을 고르는지는 최단 경로 알고리즘 고르기에 있다.
BFS가 큐로 "가까운 순서"를 보장한다면, 다익스트라는 우선순위 큐(최소 힙)로 "누적 거리가 짧은 순서"를 보장한다고 이해하면 된다.
구현 1: 단순 버전: O(V²)
매번 거리 테이블 전체를 훑어 최솟값 정점을 찾는다. 정점이 수천 개 이하일 때만 쓸 수 있다.
import sys
input = sys.stdin.readline
INF = int(1e9)

n, m = map(int, input().split())
start = int(input())
graph = [[] for _ in range(n + 1)]
for _ in range(m):
    a, b, c = map(int, input().split())
    graph[a].append((b, c))          # a → b 비용 c

visited = [False] * (n + 1)
distance = [INF] * (n + 1)

def get_smallest_node():
    min_value, index = INF, 0
    for i in range(1, n + 1):
        if not visited[i] and distance[i] < min_value:
            min_value, index = distance[i], i
    return index

def dijkstra(start):
    distance[start] = 0
    for _ in range(n):
        now = get_smallest_node()
        if now == 0:                 # 더 이상 도달 가능한 정점이 없음
            break
        visited[now] = True
        for nxt, cost in graph[now]:
            if distance[now] + cost < distance[nxt]:
                distance[nxt] = distance[now] + cost

dijkstra(start)
for i in range(1, n + 1):
    print("INFINITY" if distance[i] == INF else distance[i])
구현 2: 힙 버전: O(E log V)
최솟값 정점 찾기를 heapq에 맡긴다. 실전에서는 거의 항상 이 버전을 쓴다.
import heapq
import sys
input = sys.stdin.readline
INF = int(1e9)

def dijkstra(graph, start, n):
    distance = [INF] * (n + 1)
    distance[start] = 0
    pq = [(0, start)]                       # (누적 거리, 정점)
    while pq:
        dist, now = heapq.heappop(pq)
        if dist > distance[now]:            # 이미 더 짧은 거리로 처리된 정점
            continue
        for nxt, cost in graph[now]:
            new_dist = dist + cost
            if new_dist < distance[nxt]:
                distance[nxt] = new_dist
                heapq.heappush(pq, (new_dist, nxt))
    return distance

n, m = map(int, input().split())
start = int(input())
graph = [[] for _ in range(n + 1)]
for _ in range(m):
    a, b, c = map(int, input().split())
    graph[a].append((b, c))

distance = dijkstra(graph, start, n)
for i in range(1, n + 1):
    print("INFINITY" if distance[i] == INF else distance[i])
같은 정점이 힙에 여러 번 들어갈 수 있으므로, 꺼냈을 때 기록된 거리보다 크면 건너뛰는 if dist > distance[now]: continue가 중요하다. 별도의 visited 배열이 필요 없다.
비교
| 단순 버전 | 힙 버전 | 피보나치 힙 버전 | |
|---|---|---|---|
| 시간 복잡도 | O(V²) | O(E log V) | O(E + V log V) |
| 어울리는 경우 | 정점 수가 적고 간선이 매우 많을 때 | 일반적인 경우 (정점 수만 개 이상) | 이론상 가장 낮은 경계. 상수가 커서 실무·코딩 테스트에서는 이진 힙을 쓴다 |
1956년에 고안된 원래 알고리즘이 단순 버전이다. O(V²)는 전국 도로망처럼 정점이 수백만 개인 그래프에서는 감당할 수 없어, 최솟값 정점 찾기를 우선순위 큐에 맡기는 쪽으로 개선됐다. 지도 앱의 길 찾기도 이 계열의 알고리즘에 전처리 기법을 더해 쓴다.
핵심 정리
- 다익스트라 = 가장 가까운 미확정 정점 선택(그리디) + 이웃 거리 갱신
- 음의 가중치가 없을 때만 정확하다.
heapq로 구현하면 O(E log V), 힙에서 꺼낸 거리가 낡았으면 건너뛴다.
관련 노트: BFS, 힙과 우선순위 큐, 그리디, 그래프의 기본, 최단 경로 알고리즘 고르기