목차11개 항목
출처와 참고
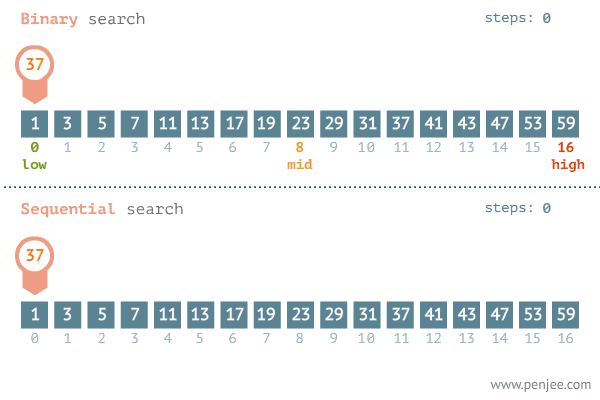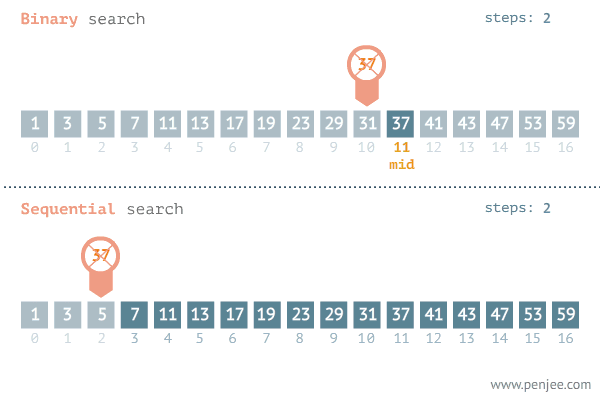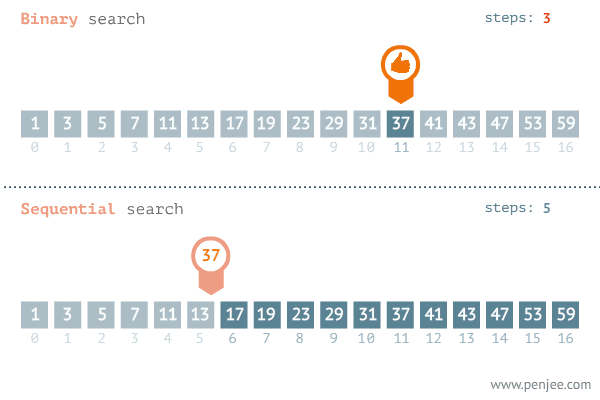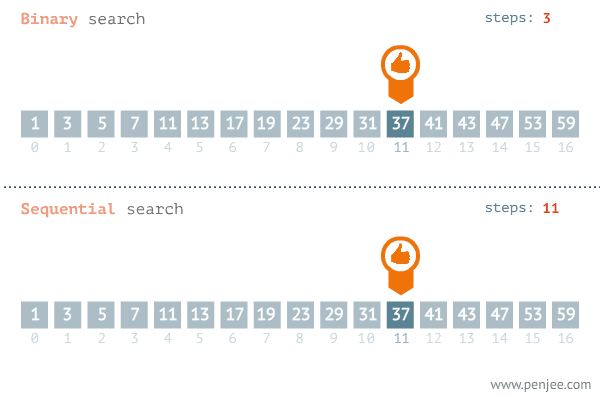
이분 탐색(이진 탐색, Binary Search)은 정렬되어 있는 리스트에서 탐색 범위를 절반씩 좁혀 가며 데이터를 찾는 방법이다. 앞에서부터 하나씩 보는 순차 탐색이 O(n)인 데 비해, 이분 탐색은 매 단계 범위가 반으로 줄어 O(log n)이다. 100만 개 중에서도 약 20번 비교면 충분하다.
순차 탐색과 비교
순차 탐색(선형 탐색, Linear Search) 은 첫 원소부터 끝까지 하나씩 비교한다. 정렬 여부와 상관없이 쓸 수 있고, 찾으면 바로 멈춘다.
def linear_search(arr, target):
    for i, x in enumerate(arr):
        if x == target:
            return i
return None| 순차 탐색 | 이분 탐색 | |
|---|---|---|
| 전제 | 없음 | 정렬되어 있어야 함 |
| 최악 (상한) | O(n) | O(log n) |
| 최선 (하한) | Ω(1), 첫 원소가 답 | Ω(1), 가운데 원소가 답 |
| 적합한 경우 | 정렬되지 않은 데이터, 한두 번만 찾을 때, 원소가 적을 때 | 같은 데이터에서 여러 번 찾을 때 |
정렬에 O(n log n)이 들기 때문에 한 번만 찾는다면 정렬 후 이분 탐색보다 순차 탐색이 싸다. 찾는 횟수가 많아지면 한 번 정렬해 두고 이분 탐색하는 쪽이 이긴다. 이름·전화번호처럼 여러 필드를 묶은 레코드는 구조체(또는 객체) 배열로 두고 키 필드를 비교해 찾는다.
동작 방식
start, end, mid 세 변수를 쓴다.
mid = (start + end) // 2위치의 값을 찾는 값(target)과 비교한다.- 같으면 찾은 것이다.
mid값이 target보다 크면 왼쪽 절반(end = mid - 1), 작으면 오른쪽 절반(start = mid + 1)만 남긴다.start > end가 되면 값이 없는 것이다.
전제 조건: 데이터가 정렬되어 있어야 한다. 정렬되지 않았다면 먼저 정렬(O(n log n))해야 한다.
왜 O(log n)인가
비교 한 번마다 남은 구간이 절반 이하가 된다. 비용을 점화식으로 쓰면 T(n) = T(n/2) + O(1)이다. k번 비교한 뒤 남은 크기는 n/2ᵏ이고, 이것이 1보다 작아지면 끝나므로 n/2ᵏ < 1, 즉 k > log₂ n이다. 따라서 비교는 많아야 ⌊log₂ n⌋ + 1번이고 O(log n)이다. 반복문 버전은 변수 몇 개만 쓰므로 공간 O(1), 재귀 버전은 호출 깊이만큼 O(log n)이다.
비교만으로 찾는 모든 탐색은 「n개 중 하나」를 가려야 하므로 예/아니오 질문이 적어도 log₂ n번 필요하다. 그래서 정렬된 배열에서 비교 기반 탐색은 이분 탐색보다 점근적으로 빠를 수 없다.
반복문 구현
def binary_search(array, target):
    start, end = 0, len(array) - 1
    while start <= end:
        mid = (start + end) // 2
        if array[mid] == target:
            return mid
        elif array[mid] > target:
            end = mid - 1     # 왼쪽 절반 확인
        else:
            start = mid + 1   # 오른쪽 절반 확인
    return None


array = [1, 3, 5, 7, 9, 11, 13, 15, 17, 19]
result = binary_search(array, 7)
print("원소가 없음" if result is None else result + 1)  # 4 (몇 번째인지)
재귀 구현
def binary_search(array, target, start, end):
    if start > end:
        return None
    mid = (start + end) // 2
    if array[mid] == target:
        return mid
    if array[mid] > target:
        return binary_search(array, target, start, mid - 1)
    return binary_search(array, target, mid + 1, end)
Lower Bound와 Upper Bound
값이 중복될 수 있으면 「x가 어디 있나」 대신 경계를 찾는다.
| 이름 | 뜻 | 파이썬 | C++ |
|---|---|---|---|
| lower bound | x 이상인 첫 위치 | bisect_left | std::lower_bound |
| upper bound | x 초과인 첫 위치 | bisect_right | std::upper_bound |
[1, 2, 4, 4, 8]에서 x = 4면 lower bound는 2, upper bound는 4다. x가 있으면 [lower, upper)가 x가 있는 구간이고, x의 개수는 upper - lower, x가 없으면 둘이 같다. 둘 다 반열린 구간 [lo, hi)로 쓰면 경계 실수가 적다.
def lower_bound(a, x):
    lo, hi = 0, len(a)                 # 답은 0 ~ len(a) 중 하나 (len(a)는 「없음」)
    while lo < hi:
        mid = (lo + hi) // 2
        if a[mid] < x:                 # mid는 답이 아니다
            lo = mid + 1
        else:                          # mid가 답일 수 있다
            hi = mid
    return lo

def upper_bound(a, x):                 # 조건만 <= 로 바꾼다
    lo, hi = 0, len(a)
    while lo < hi:
        mid = (lo + hi) // 2
        if a[mid] <= x:
            lo = mid + 1
        else:
            hi = mid
    return lo
원하는 수가 여러 번 나오는 배열에서 그 위치를 모두 찾는 문제는 배열이 정렬돼 있으면 range(lower_bound(a, x), upper_bound(a, x))로 O(log n + 개수)에 끝난다. 정렬돼 있지 않고 한 번만 찾는다면 처음부터 끝까지 한 번 훑으며 같은 값의 인덱스를 모으는 O(n)이 최선이다(100만 개면 100만 번 비교). 정렬은 O(n log n)이라 더 비싸고 원래 인덱스도 잃는다. 같은 배열에서 여러 값을 반복해 찾는다면 한 번 훑어 값 → 인덱스 목록 해시 맵을 만들어 두면 질의마다 O(1)이다.
부등호와 경계가 바뀌면
이분 탐색 버그는 대부분 경계에서 난다. 한 가지 규칙(닫힌 구간 또는 반열린 구간)을 정해 끝까지 지킨다.
| 바꾼 것 | 영향 |
|---|---|
a[mid] < x ↔ a[mid] <= x | lower bound와 upper bound가 서로 바뀐다. 중복 값이 있을 때 첫 위치 대신 마지막 다음 위치를 돌려준다 |
닫힌 구간 while lo <= hi + hi = mid - 1과 반열린 구간 while lo < hi + hi = mid를 섞음 | hi = mid를 lo <= hi와 쓰면 lo == hi == mid에서 구간이 줄지 않아 무한 루프다. 반대로 섞으면 마지막 원소를 보지 않고 끝난다 |
lo = mid(+1 없이)로 줄임 | 원소가 두 개 남으면 mid = lo라 구간이 줄지 않아 무한 루프다. 이때는 mid = (lo + hi + 1) // 2로 올림해야 한다 |
hi의 시작값을 len(a) - 1로 둠(반열린 구간에서) | 「모든 원소보다 크다」는 답 len(a)를 돌려줄 수 없다 |
mid = (lo + hi) / 2(고정 폭 정수) | lo + hi가 정수 범위를 넘을 수 있다. lo + (hi - lo) / 2로 쓴다. JDK의 Arrays.binarySearch에서 2006년에 발견돼 고쳐진 버그다 |
셋으로 나누면 더 빠를까
같은 논리로 구간을 세 개로 나눠 「1/3 지점과 2/3 지점」 두 값과 비교하면 단계 수는 log₃ n으로 준다. 그러나 한 단계에 비교가 최대 2번이라 전체 비교는 2·log₃ n = (2 / log₂ 3)·log₂ n ≈ 1.26·log₂ n으로 오히려 늘어난다. 빅오는 둘 다 O(log n)이다. k개로 나누면 비교가 (k-1)·log_k n으로 k가 클수록 커지므로, 메모리 안에서는 둘로 나누는 것이 비교 수가 가장 적다. 한 번 읽는 비용이 비교보다 훨씬 비싼 디스크에서만 여러 갈래로 나누는 쪽(B 트리)이 이긴다(트리와 이진 탐색 트리). 정렬된 배열이 아니라 봉우리가 하나인 함수의 최댓값을 찾는 「삼분 탐색」은 이름만 같은 다른 기법이다.
파이썬 bisect 라이브러리
정렬된 리스트에서 값을 삽입할 위치를 이분 탐색으로 찾아 준다.
bisect_left(a, x): 정렬을 유지하며 x를 넣을 수 있는 가장 왼쪽 인덱스bisect_right(a, x): 정렬을 유지하며 x를 넣을 수 있는 가장 오른쪽 인덱스
from bisect import bisect_left, bisect_right

a = [1, 2, 4, 4, 8]
print(bisect_left(a, 4))   # 2
print(bisect_right(a, 4))  # 4

# 값이 [left, right] 범위에 있는 원소의 개수
def count_by_range(a, left, right):
    return bisect_right(a, right) - bisect_left(a, left)

print(count_by_range(a, 4, 4))  # 2
파라메트릭 서치 (Parametric Search)
"조건을 만족하는 값 중 최댓값/최솟값을 구하라" 같은 최적화 문제를 예/아니오로 답하는 결정 문제로 바꿔 이분 탐색으로 푸는 기법이다. 데이터 배열 자체가 아니라 답의 범위를 이분 탐색한다.
예: 떡을 높이 H로 잘랐을 때 잘린 떡의 합이 M 이상이 되는 가장 높은 H 구하기
def max_cut_height(heights, m):
    start, end = 0, max(heights)
    result = 0
    while start <= end:
        mid = (start + end) // 2
        total = sum(h - mid for h in heights if h > mid)
        if total >= m:      # 조건 만족 → 더 높여 본다
            result = mid
            start = mid + 1
        else:               # 부족 → 낮춘다
            end = mid - 1
    return result

print(max_cut_height([19, 15, 10, 17], 6))  # 15
답의 범위가 10억처럼 커도 약 30번만 판정하면 된다.
핵심 정리
- 정렬된 데이터에서만 사용, 시간 복잡도 O(log n)
- 비교마다 구간이 반으로 줄어 비교는 ⌊log₂ n⌋ + 1번이다. 셋으로 나누면 비교가 오히려 1.26배 는다
- 중복 값은 lower bound(이상인 첫 위치)·upper bound(초과인 첫 위치)로 다루고, 개수는 둘의 차다
- 경계 조건(
start <= end,mid ± 1)을 한 가지 구간 규칙으로 정확히 지키는 것이 핵심 - 파이썬에서는
bisect로 간단히 구현할 수 있다. - 답의 범위를 이분 탐색하는 파라메트릭 서치로 최적화 문제도 풀 수 있다.
관련 노트: 분할 정복, 빅오 표기법, 최장 증가 부분 수열, 이진 탐색 트리